今天写完文章,照例用我的脚本,将Markdown文件“编译”成HTML,然后复制粘贴进微信公众号后台。
刚贴进去,编辑器上方就跳出了离奇的报错:
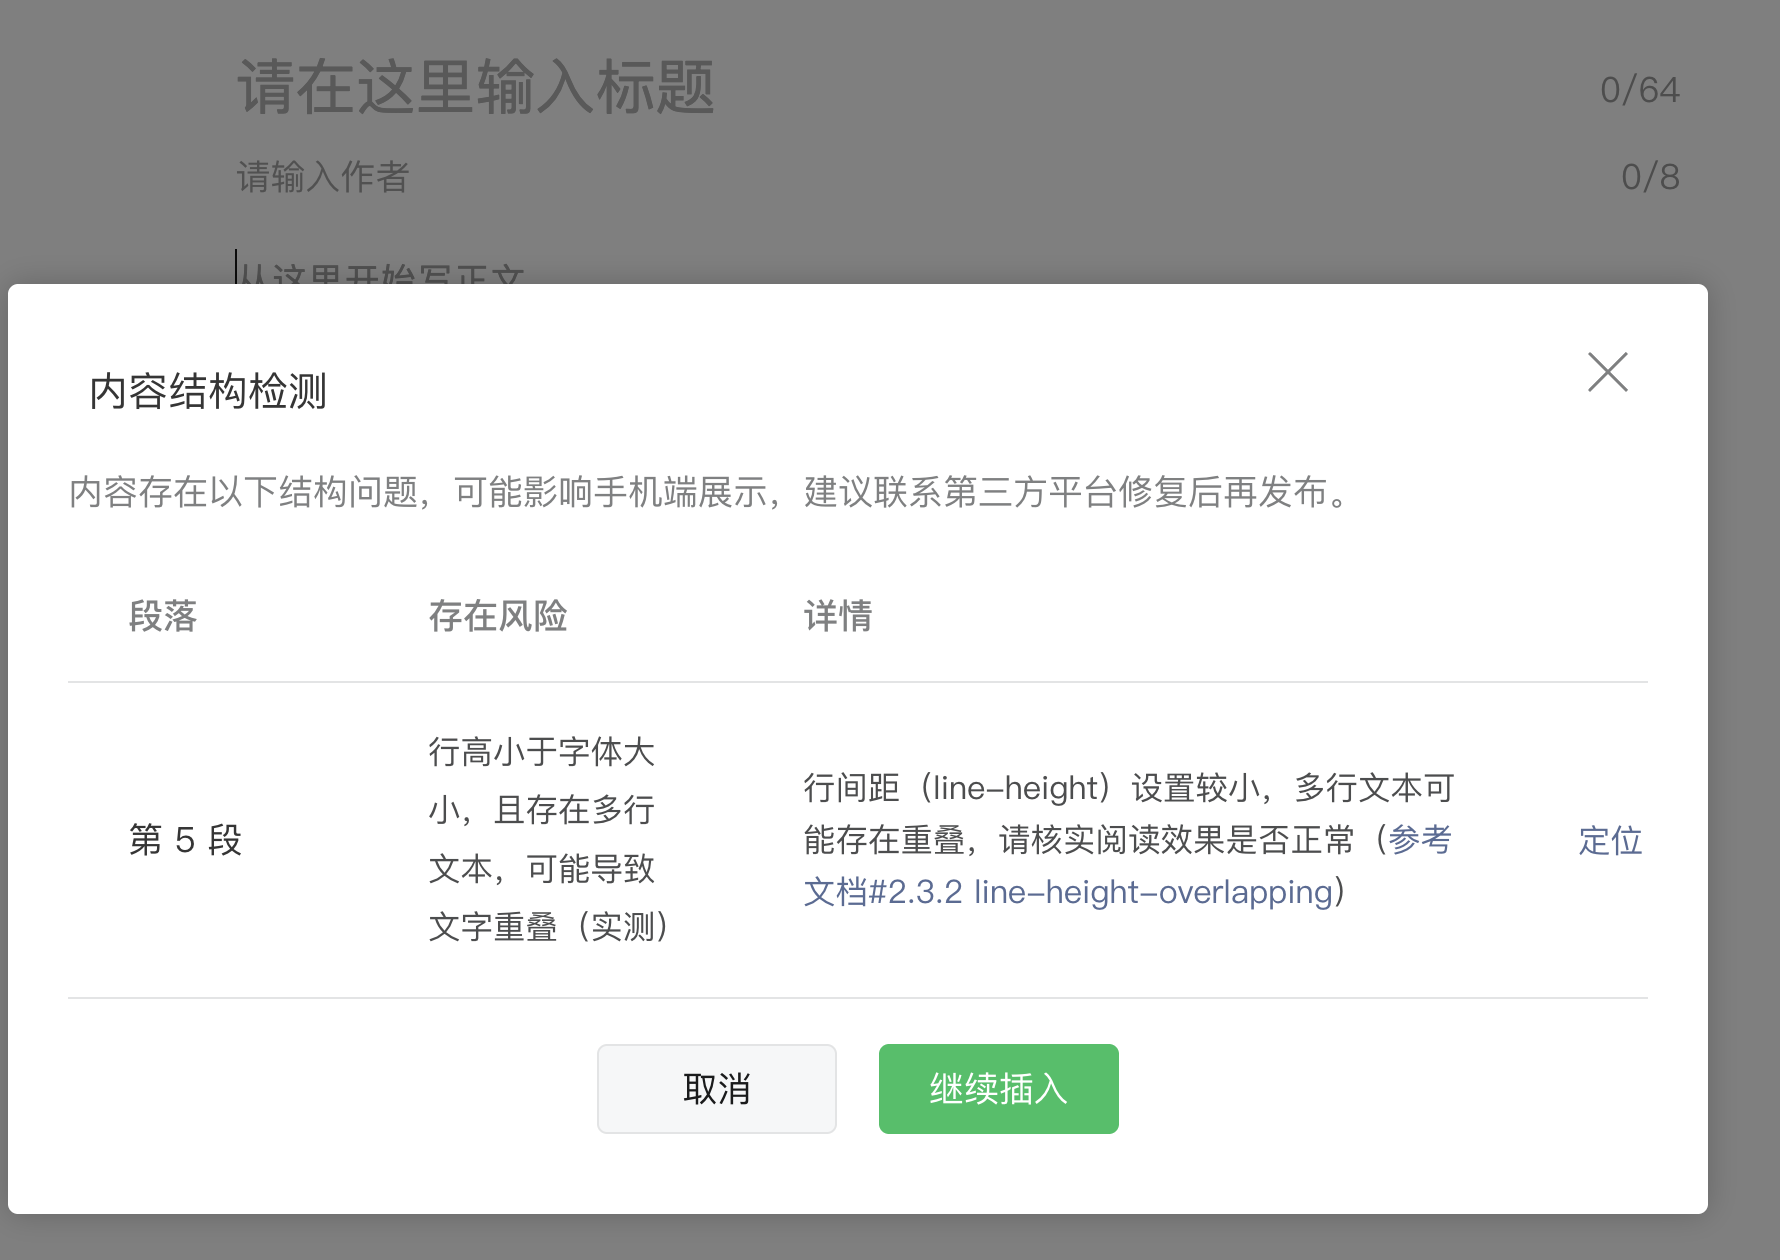
我这个脚本程序用了许久,一直没有出错,所以突然看到这样的报警,有些不知所以然。
如果放在以前,遇到这种微信平台的“玄学报错”,大概率只能靠猜:把加粗去掉试试,把行距再调大一点试试,或者加两个空行碰碰运气。
但这回我什么也没折腾,直接把后台弹出来的这几行报错文字,连同刚生成的 HTML 随手复制下来,扔给正在协助我写作的 AI:
刚刚定稿生成的 HTML,粘贴到微信公众号编辑器中出现下面的提醒,请看看如何优化。
接下来的几分钟里,AI 展现出来的排查和解决过程,完全超出了我对“让 AI 帮我改改格式”的预期。
AI 是怎么当侦探的
它没有像传统的问答机器人那样,给我回复一堆“建议您检查 CSS 是否冲突”之类的车轱辘话。
它先是扫了一眼那几个报错段落的源码,立刻捕捉到一个耐人寻味的规律:
全文几十个段落,纯文字段落一个都没报警。唯独第 2 段、第 9 段和第 19 段被精准揪了出来——恰好是全篇仅有的三个包含了超链接、斜体注释或加粗文字的地方。
但这还只是第一步。顺着微信报错提示里的文档链接,AI 竟然找到了微信官方开源的排版检测工具仓库(verify-article-structure-spec)。原来微信公众号后台在粘贴文章时,就是在跑这套工具抓违规。
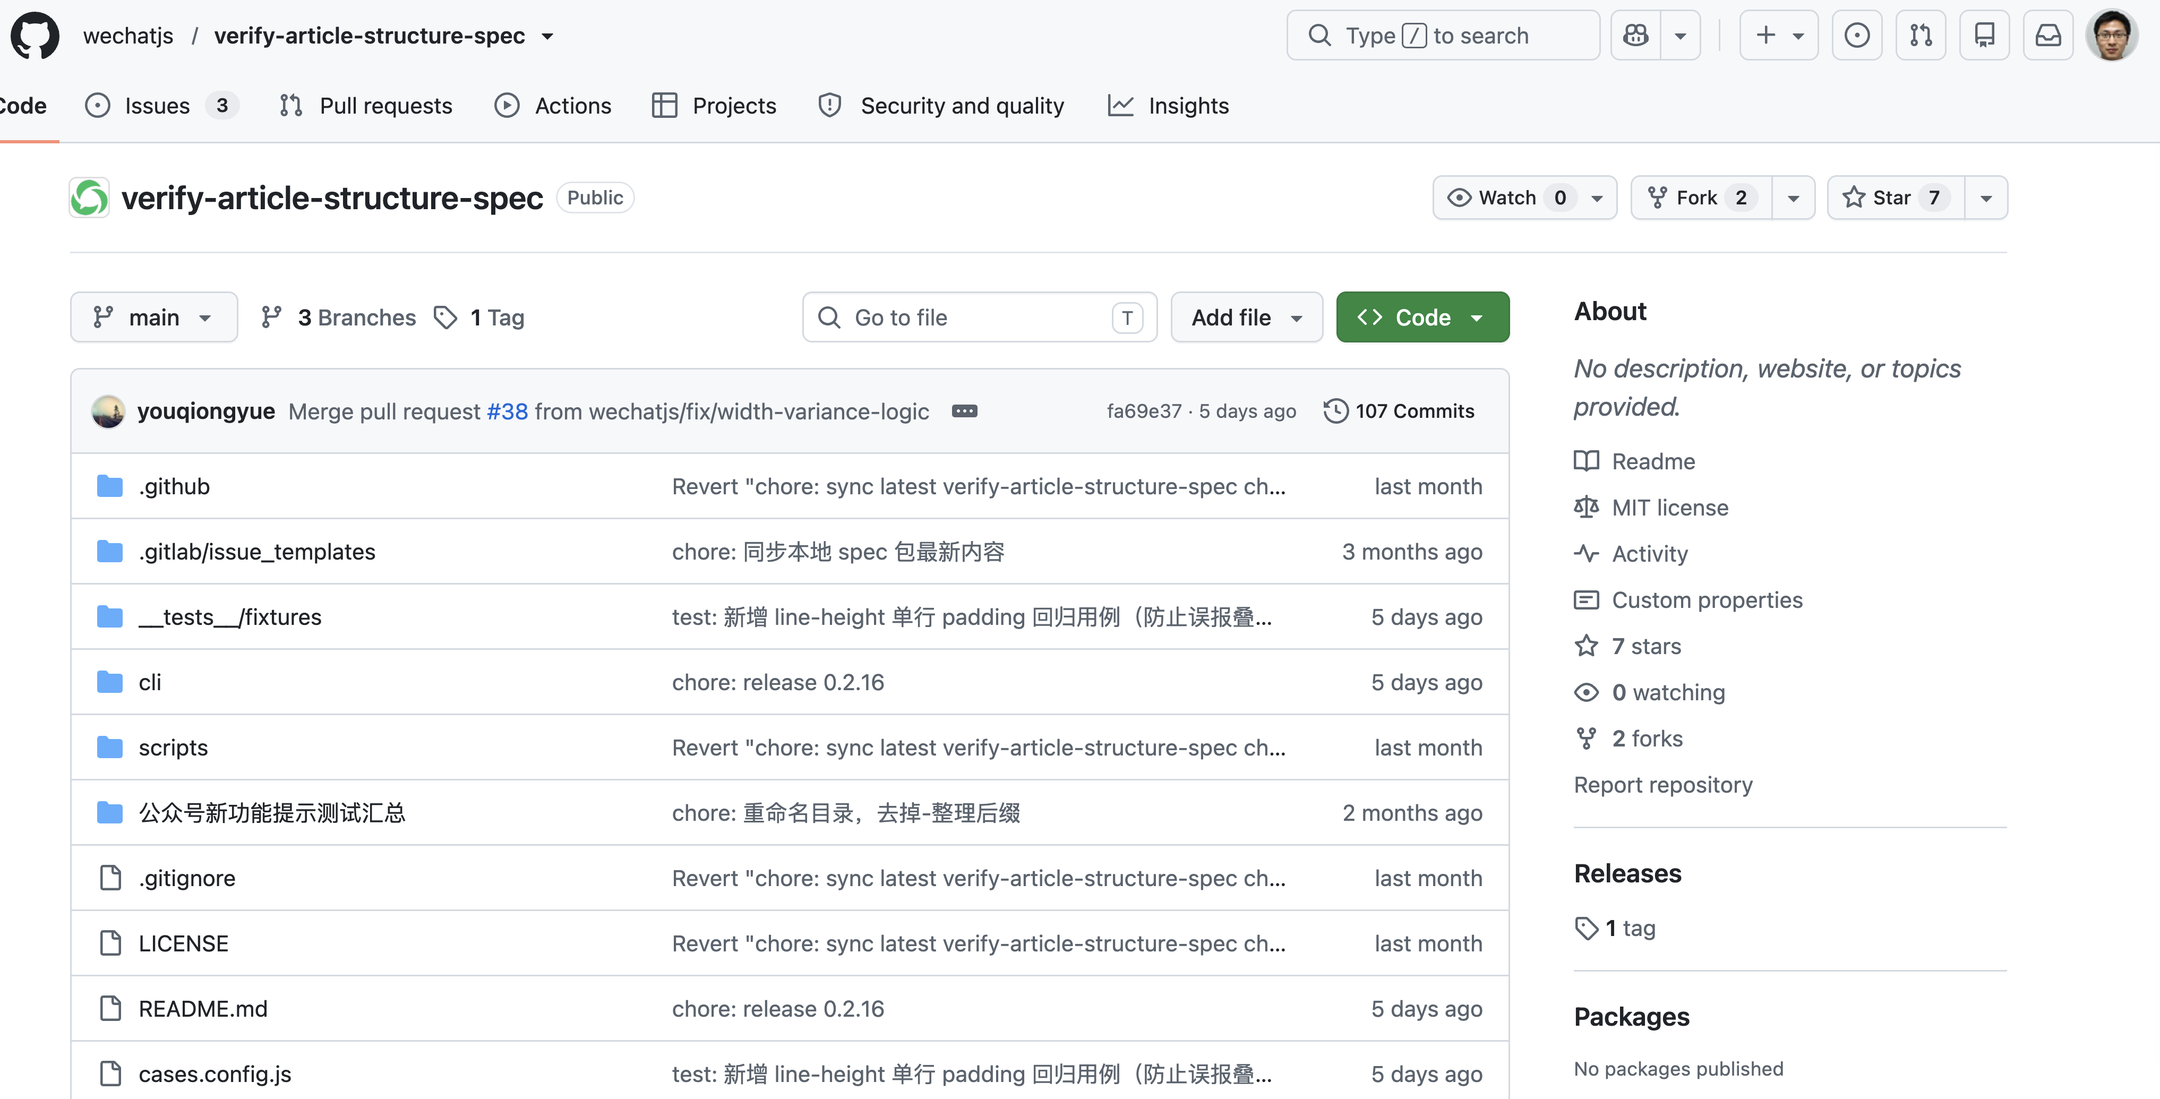
紧接着,AI 做了一件极其硬核的事:直接在本地把这套工具克隆下来,调用我电脑里的 Chrome 浏览器,用微信官方的规则实地跑了一遍我的文章。
终端里随即弹出了和公众号后台一模一样的 3 条红色报错,100% 完整复现。
顺藤摸瓜揪出微信的“算法乌龙”
既然把工具抓到了本地,源码自然瞒不住了。
AI 顺着调用栈直接读进了微信检测工具的 TypeScript 源码,几分钟内就帮我把微信底层的判定逻辑扒了个底朝天。
原来,微信检测“文字是否重叠”,根本不是看你的 CSS 样式表里写了多少 line-height,而是用真实浏览器在后台偷偷去“量”文字的高度。
算法的设计思路很直接:用浏览器测出文本的总高度,再数一数“一共有多少行”,两者相除算出平均每行的高度。如果平均行高小于字号的 95%,它就判定你多行文字挤在了一起。
可滑稽的地方,恰恰出在浏览器怎么数“行数”上。
在浏览器的底层机制里,只要一句话里出现了超链接、加粗或者斜体标签,浏览器在测量文字切片时,就会把同一行字顺着标签切成好几截。
比如我文中的一句话:写了《科技固收+,不敢认同》,读者有不少讨论。
在人眼里,这是整整齐齐的 1 行字,总高度大概 22 像素。
但在微信检测器的切片逻辑里,中间那个带链接的书名号把整行切成了 4 截碎块。检测器傻乎乎地把这 4 个碎块当成了“4 行字”,然后拿 22 像素除以 4,得出了一个“平均行高只有 5.5 像素”的结论。
5.5 像素自然远远小于 16 像素的字号。于是检测器警铃大作,自作聪明地判定作者把 4 行字叠在了一起,黄色警告就这样直接甩在了我面前。
顺手修好,一劳永逸
摸清了这个乌龙机制,解法就变得格外轻巧。
AI 在微信检测器的源码里发现:检测器只去扫描那些直接包含裸文本的段落。
如果段落内容全部套在一层干净的 <span> 标签里,检测器就会自然略过它,不再去执行那套容易犯糊涂的分片测量;而 span 标签本身又不在它的检测名单里。
这就好比给段落穿上了一件隐形衣:读者看到的样式、字号、暗色模式不受任何影响,但微信那个漏洞百出的检测器却会被直接绕开。
AI 没让我动手改任何一行代码,直接定位到我本地的 Markdown 转微信 HTML 脚本,在输出段落时自动加上了这层包裹逻辑。改完后在本地重新跑了一遍微信官方检测工具:违规瞬间清零。
再把新生成的文章往公众号后台一贴,警告消失了。
这才是 AI 该有的样子
整个排查和修复过程,前前后后不过几分钟。
作为使用者,我全程只做了一件事:把微信后台弹出的报错复制下来,随手甩给 AI。我不用知道微信的检测工具叫什么名字,不用去读排版规范,更不用在终端里敲任何命令。
以往面对平台各种莫名其妙的玄学报错,创作者往往只能在论坛里到处打听、不断试错,最后带着将信将疑的心情妥协。
而现在,AI 就像一个随时待命的资深工程师:看到症状,顺着线索抓出官方工具复现,读源码定位病因,最后直接把修复补丁打进你的工作流里——甚至连这篇分享推文,95%都是由AI完成*(谁让我是甩手掌柜,对修复全程压根说不清)*。
这种把所有繁琐与不确定性随手交给 AI、然后“被稳稳接住”的体验,大概就是今天技术工具流最迷人的地方。