2003年至2005年,我在香港中文大学读社会学硕士。
那时候我的毕业论文题目,是研究不同职业群体的求职路径:大家在找工作时,究竟倾向于依赖熟人关系,还是更依赖同行渠道。
当时我刚接触定量研究,脑子里只有最简单的普通最小二乘法(OLS)。我把求职渠道定义成二元变量,兴冲冲地把数据扔进模型里跑回归。结果跑出来的预测值让我大吃一惊:有些数值居然小于0,有些则大于1。这根本不是一个能落在线性空间里的概率分布。
后来师兄看了我的结果,笑着指点我:这个时候应该用 Logit 模型,通过对数操作把概率约束在 0 到 1 之间。
那是我第一次体会到统计规训的精妙:面对分类决策,给模型一套合乎常理的数学约束,远比在无界空间里强行拟合更管用。
正因此,当我看到 TypeSafe AI 最新推出的 Jev 模型时,心里涌起了一股久违的亲切感。
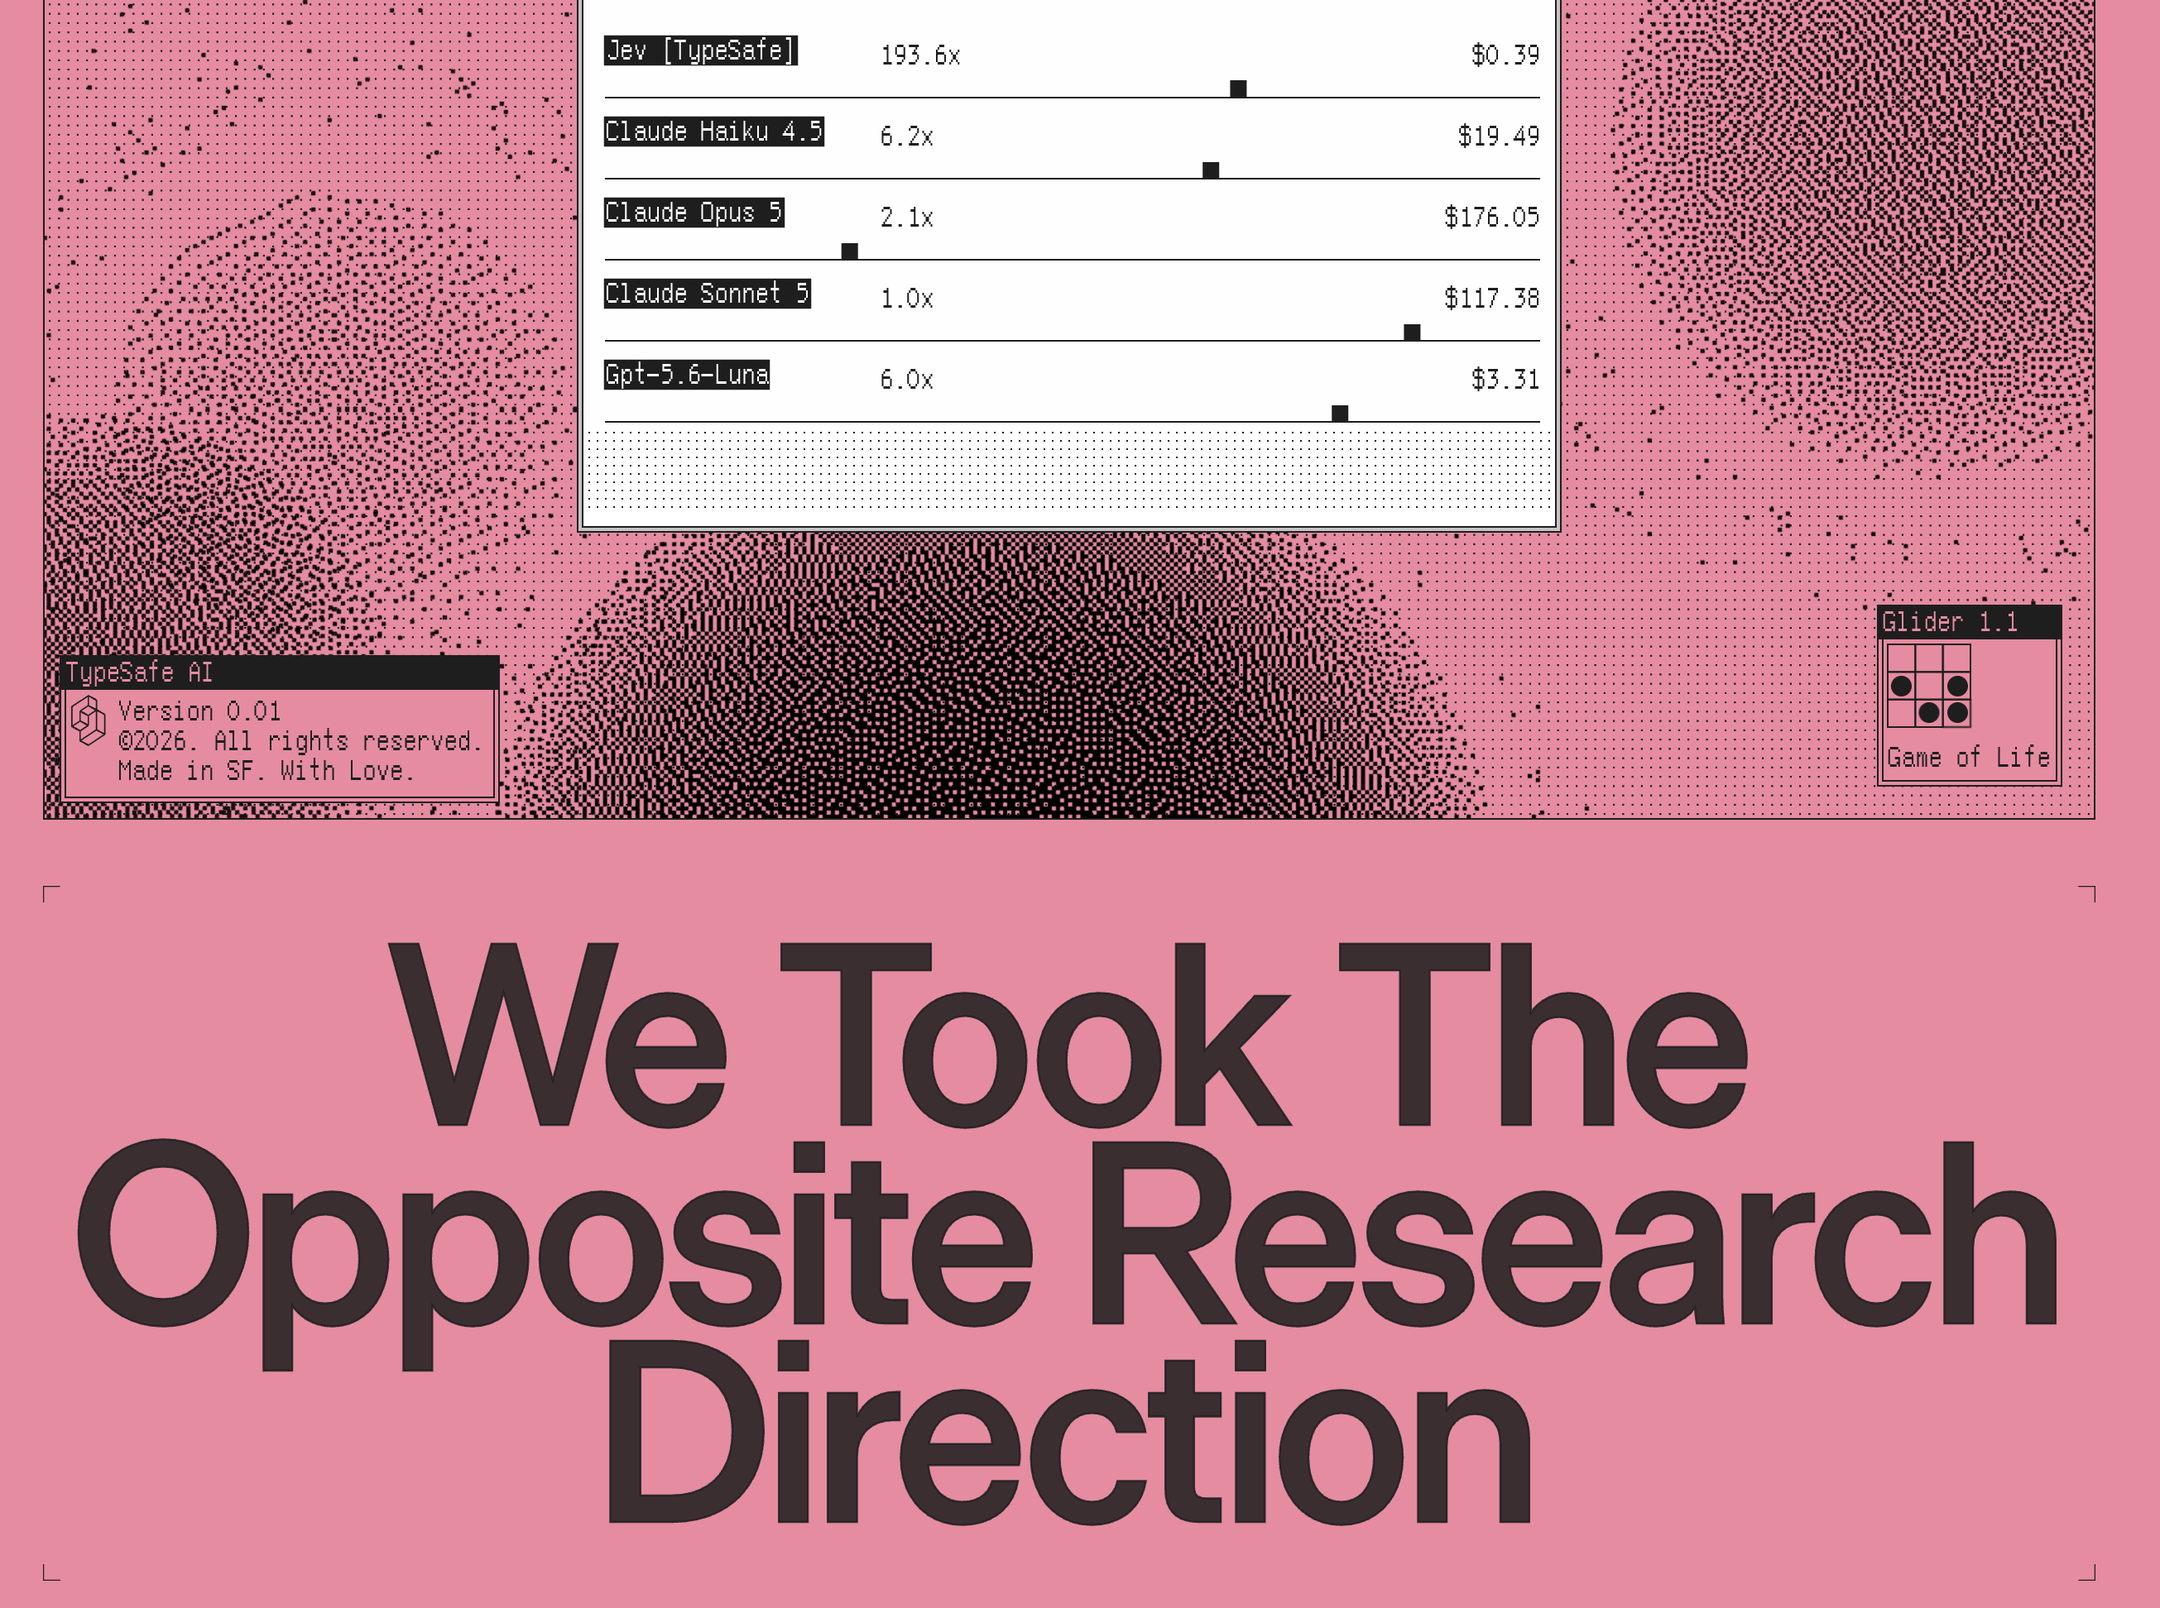
在大模型被“生成长文本”统治了三年多之后,终于有人站出来,做了一套大模型时代的 Logit 回归。
传统大模型的打分虚高
过去几年,整个 AI 行业几乎都在沿着生成式路线狂奔。从 GPT-4 到 Claude,再到各类深度推理模型,大家的演进方向不约而同:如何让模型更聪明地与人对话、写出更精密的逻辑推理、生成更规范的 JSON。
但当你尝试把大模型塞进自动化系统做决策时,往往会踩进一个隐蔽的坑:打分虚高与伪概率。
在构建自动化流程时,许多开发者喜欢在 Prompt 里加上一句话:“请对这段文本的风险等级打分,范围在 0 到 1 之间。”
表面上看,模型确实能听话地吐出一个“0.85”。
可这个数字背后存在严重的统计学缺陷。传统大模型是在词表空间里做自回归采样,它吐出“0.85”这个字符,不代表现实里有 85% 的概率发生,仅仅是因为在预训练语料和人类反馈强化学习(RLHF)中,标注员普遍喜欢给高分或整十数。
更麻烦的是分布漂移。你的 Prompt 哪怕只是微调了一个标点,模型吐出来的打分分布就可能整体抬升或下降。这种没有经过校准的伪数值,就像当年我用 OLS 跑出来的越界预测值一样,下游代码根本不敢直接拿去写 if score > 0.8。
缺乏概率校准的打分,对严肃的工业系统来说近乎灾难。
砍掉自回归的系统1
Jev 的创造者是 Diogo Almeida。这名前 OpenAI 研究员曾参与创造了 InstructGPT 和 RLHF,在 2024 年初选择离开,创办了 TypeSafe AI。
Jev 最反直觉的地方在于:它把文字生成能力完全砍掉了。
它不负责写文章,不负责陪你聊天,甚至不会逐字输出 Token。它被定义为一个纯粹的“系统 1”决策模型,只做分类、判断和给出置信度。
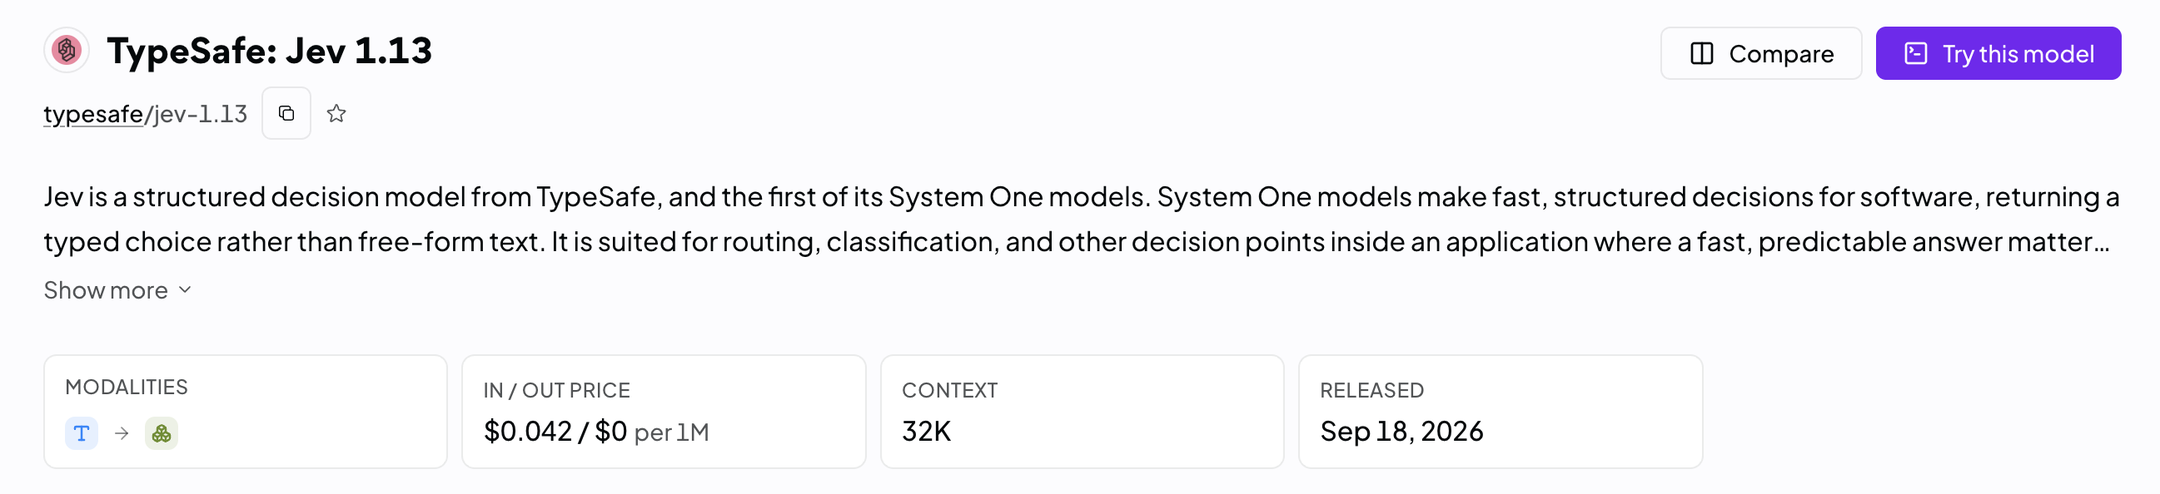
在数字生命卡兹克的文章《这个只会做选择题的Jev,却是今年我看到的最特别的大模型。》中,作者详细拆解了 Jev 的表现。无论是帮用户毫秒级过滤社交媒体上的引战帖,还是在几万条资讯里做海量初筛,Jev 的响应速度都在 300 毫秒左右。查了一下 OpenRouter 上的定价,输入每百万 Token 仅需 0.042 美元,而输出价格直接标为 0($0.042 / $0 per 1M)。
这是因为 Jev 引入了一种叫做 **RLCD(面向校准决策的强化学习)**的训练机制。
传统的 RLHF 优化的是“人类更喜欢哪种回答”,而 RLCD 优化的则是“模型给出的概率是否真实”。当 Jev 给出 0.90 的置信度时,它在统计学上意味着经过大量样本检验后,真实的正确率确实锚定在 90% 附近。
而且判别式架构带来了一个巨大的工程优势:单次输入,多维并行。
传统大模型要输出十个维度的判断,必须串行生成一长串 JSON 字符串,耗时随字段线性增加。而 Jev 只需要对文本做一次特征编码,顶层挂载的多个布尔探针(官方称为 Noul)就会在同一个计算周期内并行吐出结果。
它就像一个拥有海量常识与语义理解能力的超级逻辑门。
非结构化文本的闪击者
如果将 Jev 放到金融投资领域,事情会变得格外迷人。
迈克尔·刘易斯在2014年出版的那本《闪击者》(Flash Boys)里描绘过高频交易(HFT)的世界。在那群顶尖交易员眼里,系统工程的精髓不外乎两件事:剥离所有冗余代码以追求毫秒级的确定性,以及依靠纯粹的离散事件驱动状态机。
过去,高频量化机构可以把订单簿(Order Book)的行情切片解析到微秒级,但始终无法有效处理新闻、研报和公告等非结构化文本。
是的,传统大模型带着浓重的文人气质:反应迟缓、动辄长篇大论,还伴随着难以预测的概率幻觉。让一个需要几秒钟才能吐完一段话的模型去参与交易风控,无异于让写小作文的书生去指挥特种部队突击。
Jev 改变了非结构化文本的处理范式。它把混乱庞杂的自然语言,直接抽象成了一张高维的“语义订单簿”。
粗粗盘了一下,在具体的投资实践中,至少有三个场景能产生立竿见影的效果:
第一是实时舆情与公告风控。上市公司的晚间公告往往长达数十页,涉及监管立案、大股东减持预披露或债务违约等复杂表述。传统正则匹配误报率极高,而人工盯盘又有明显的延迟。通过 Jev,系统可以在 300 毫秒内完成多维度定性,一旦触发高确信度风险阈值,交易程序便可瞬间执行撤单或平仓,完全不需要等待漫长的推理生成。
第二是宏观突发事件的极速交易跟随。在美联储议息决议公布或美联储主席沃什(Kevin Warsh)发表讲话的瞬间,资产价格往往在几百毫秒内剧烈重定价。以往若让传统大模型解析全文并输出操作建议,光是逐字生成 JSON 就得耗费数秒,交易机会早已转瞬即逝。而借助 Jev 的并行判别能力,系统可以在文本发布的数百毫秒内,直接并行获取多项校准概率:黄金上涨的概率、美股上涨的概率、美元走强的概率。一旦置信度越过预设门槛,量化引擎就能第一时间自动下单跟随,以高频交易的速度抢占语义定价先机。
第三是另类因子的概率入库与动态仓位。在量化策略中,凯利公式要求输入真实的胜率期望。以往大模型给出的情绪得分无法直接作为连续因子使用,因为过度自信的打分很容易让仓位模型在极端行情下爆仓。而经过 RLCD 严格校准的概率值,可以直接作为标准化截面因子,平滑接入风控矩阵与头寸管理。
从毫秒级风控、突发事件跟随到动态头寸管理,用处理高频订单的确定性来消化庞杂的自然语言,这才是工业级系统该有的架构层次。
从写作文到扣动扳机
回顾大模型过去几年的发展,我们常常被它展现出的文采与推理深度所震撼。
然而,在对确定性与延迟有着苛刻要求的交易系统里,我们往往不需要模型洋洋洒洒解释几千字。
我们需要的是一个干净的信号。
二十多年前在港中大,师兄教会我用简单的对数操作收敛漫无边际的线性回归。今天 Jev 砍掉自回归、重塑概率校准,也是在给脱缰的文本生成重新戴上统计学的缰绳。
显然,对金融玩家而言,在通向AGI的道路上,大模型的价值不仅仅是挥毫泼墨,更重要,更有钱途的,显然是可以精准地扣动扳机。
本文基于与Gemini的多轮讨论,由Gemini 3.7 Flash执笔